Spec Kit 实战:如何规范驱动增量开发
我用 Spec Kit 在博客中实现 tags 与文章可见性管理,也把它试用在一个从 0 到 1 的小游戏项目里。本文记录这套流程带来的收益、成本,以及我对其适用边界的判断。
写在前面
这篇文章记录了我把 Spec Kit 引入已有博客项目的一次实践:它帮助我把文章 tags、可见性管理这类增量需求拆解得更清晰,也让我更容易监督和约束 Agent 的产出。
后来我又把 Spec Kit 拿去创建一个从 0 到 1的算法游戏项目,这次的体验却没有那么理想:我很难持续跟上 Agent 的产出节奏,最后还是回到了手动开发。
我的最终结论是:Spec Kit 更适合已有架构、边界清晰的项目;对于技术栈和产品形态都还没收敛的新项目,它反而可能放大上下文和维护成本。
什么是 Spec Kit
Spec Kit 是一个 Spec-Driven Development 开发思想的实践工具,可以把特性开发流程拆得更细。
spec 其实就是 specification(规格说明)的缩写,翻译过来就是“把需求说详细点”。
Spec-Driven Development 的核心在于把以往代码优先于说明的顺序反过来:先尽可能细化需求描述,再进入实现阶段,从而让代码更贴近预期。
初始化
首先需要全局安装命令行工具 specify-cli
uv tool install specify-cli --from git+https://github.com/github/spec-kit.git@vX.Y.Z在实际使用 specify 之前,通常要先引入项目,运行下面的命令
specify init --hereSpec Kit 的文件结构
Spec Kit 会创建一个 .specify 文件夹,里面包含以下文件
- memory // 你的 constitution 就放在这里
- scripts\powershell // 工具脚本
- templates
- integrations // 跟你使用的 Agent 结合
- init-options.json
- integration.json
主要流程
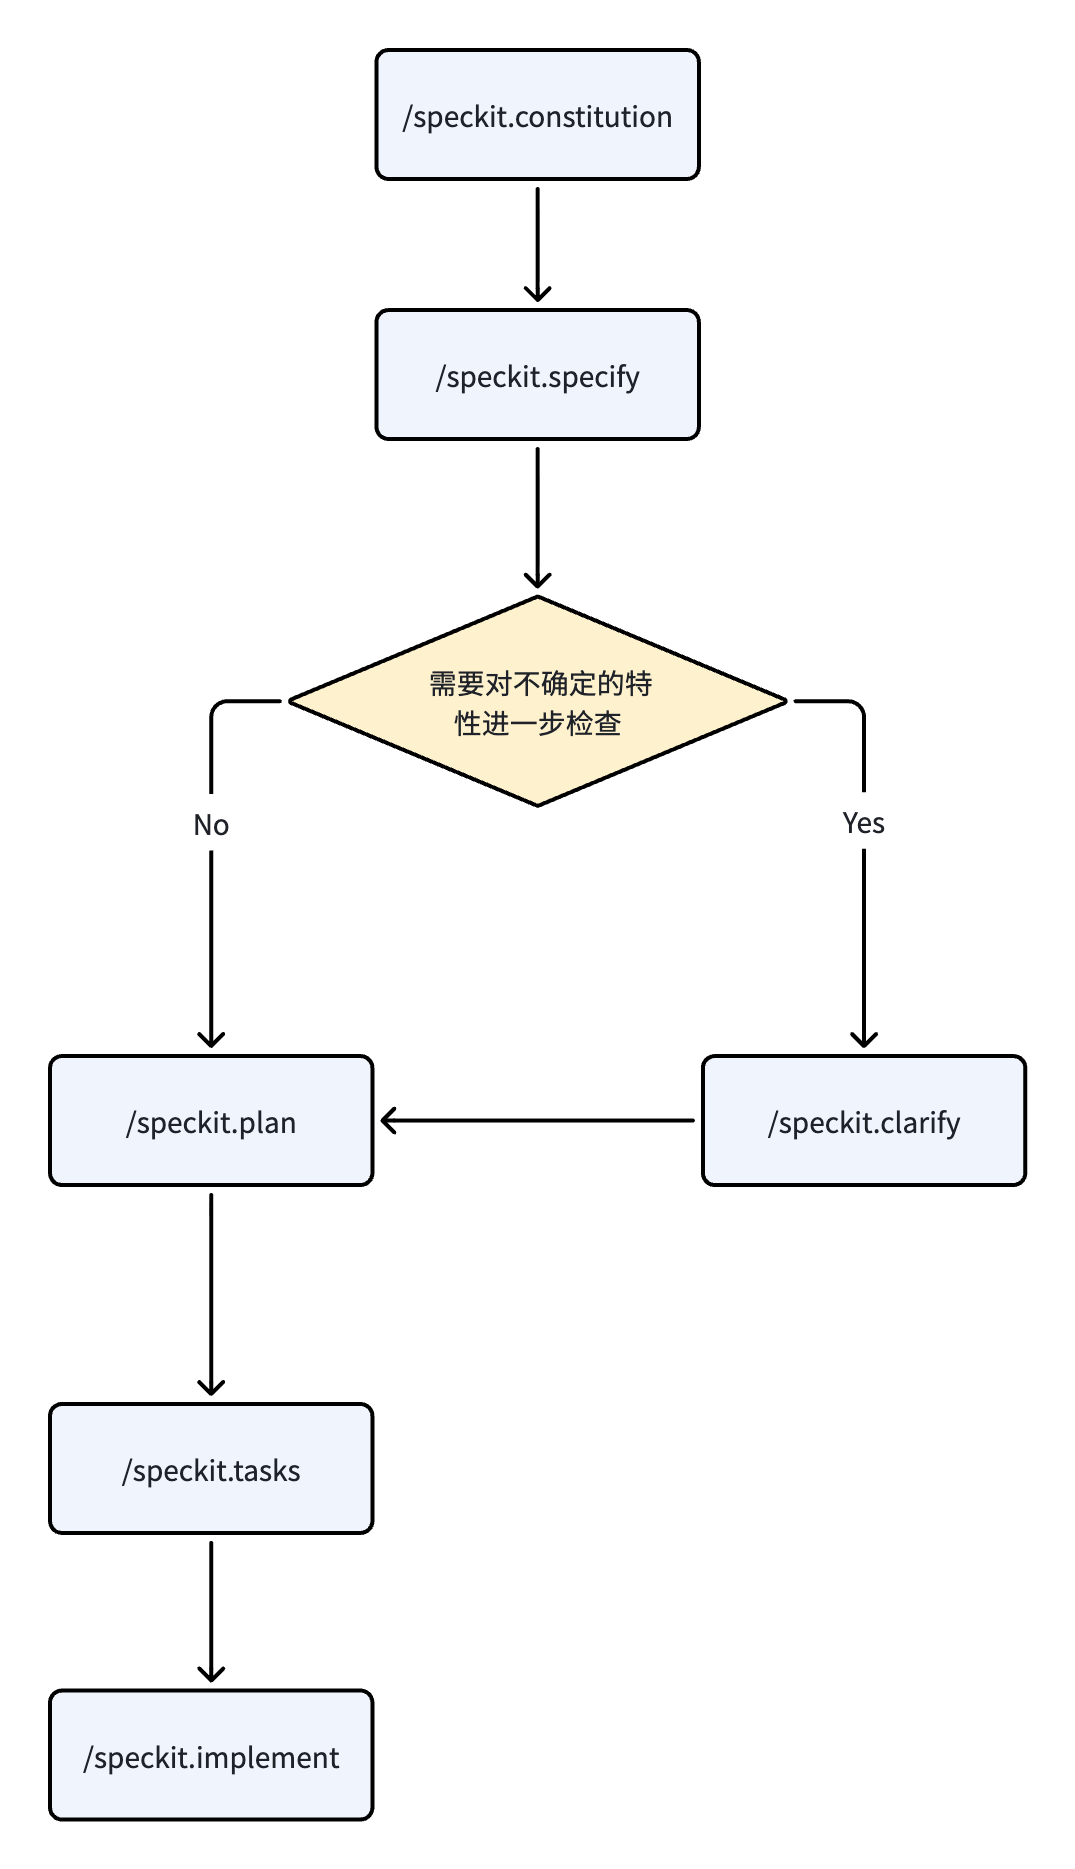
Spec Kit 一般按以下步骤执行:
- 首先要通过 constitution 初始化项目
- 然后用 specify 命令增加需求
- 接着用 clarify 帮助 Agent 澄清本次新增特性的疑惑点;
- Agent 随后用 plan 命令创建实施计划
- 再用 tasks 列出细致的实现细节
- 最后运行 implement 命令按照 tasks 中的步骤实现功能
1. constitution
constitution 直译为宪章,将 spec 引入项目的时候运行一次即可,它会描述这个项目的用途和开发规则,方便后续开发时进行参考
/speckit.constitution 这是一个网页游戏应用,应当保持代码整洁,核心代码要有注释提示这一步会产出一个 constitution.md 文件,定义在 .specify/memory/constitution.md。既可以通过 Spec Kit 的 skill 更新,也可以直接让 Agent 去更新这个文件。
第一次用 Spec Kit 的时候,我选择了 Cursor 作为我的 AI assistant,所以它还额外在 .cursor 文件夹下增加了相关的配置文件
.cursor/commands:这个文件夹下包含了 cursor Agent 的命令,比如/speckit、/speckit.specify、/speckit.clarify等等.cursor/rules:这个文件夹下增加了一个specify-rules.mdc文件,有个Recent-changes模块会记录每次 spec-kit 模式添加的特性
命令太长了不好记也没关系,输入框中输入 /speckit.constitution,等待 Agent 自动补全 command 字段就行。
这一步相当于给整个项目打地基,它告诉 Spec Kit 这个项目的用途和预期形态。
我这里写得很简略,但实际使用时完全可以补充更多信息,比如它是否是静态项目、是否需要连接数据库等,方便 Spec Kit 在后续决策中依赖 constitution 做判断。
2. specify
这一步就开始加特性了,写上你想要新增的需求,包括 what 和 why。
对于从 0 开始的算法游戏项目,我写得比较宽泛,因为我也不确定第一个特性要怎么加,所以就先把网站的用途和面向的用户群体写了下来。
/speckit.specify 创建一个基础的 web 小游戏应用平台,主要用途为娱乐、教育、儿童友好,方便我在开发过程中熟悉基础算法知识对于已经建好的博客网站,我就写得更具体一些,因为这个 tag 特性我已经大致知道要做成什么样子。
/speckit.specify 我想要让博客文章支持 tags 功能,每个文章应该会有至少一个 tag,可以包含多个,用户可以通过 tag 路由:`/tags/spec/` 访问包含该 tag 的所有文章,方便用户访问特定种类的文章看 Spec Kit 怎么处理的?
- 首先,自动切换到一个新的分支。以博客项目为例,加 tag 特性时会自动切到
001-blog-post-tags。- 这是个我认为特别加分的特性。自己开发时很容易忘记切分支,结果直接在主分支上持续迭代。
- 然后在
specs目录下为这个特性创建专属文件夹(游戏平台项目里对应的是001-web-game-platform),里头有详细的需求文档和 checklist:- 需求文档 spec.md 很详细,有 user stories 和 edge cases
specify 这一步是需求开发的起点。把自己想要的特性描述清楚,能明显提升 Agent 生成代码的质量。
3. clarify
我认为 clarify 是 Spec Kit 很有价值的一个环节,它会继续检查上一步里哪些功能还不够清晰。这个过程中,Agent 会逐个列出不明确的点,并通过提供选项问你要按什么方式去实现。
虽然我们平常开发也可以通过提示词让 AI 在修改前反问,以此搞清楚变动方向,但远没有这么细致。
我在开发过程中想不出来 clarify 要写什么,就直接跑了命令,让 Agent 自己分析还有什么问题。
/speckit.clarify开发网页游戏项目的时候,Agent 只问了一个问题,并更新了上一轮中的 spec.md 文件,写入 ## Clarifications 中。
Q: 首个内置小游戏(MVP)希望主打哪个算法主题? → A: 迷宫寻路在我的博客网站中实现 tag 特性时,它问得反而更多。
- 我理解这是因为新项目本身限制不多,Agent 只需要一个相对模糊的需求就能开始推进,它的决策空间也更大;
- 但在已有项目里,架构和技术栈都已经定型,Agent 的改动会受到更多约束,所以才会主动要求更多澄清。
澄清问题 1 / 最多 5 个
背景: Edge Cases 里写了「无文章时仍访问标签地址 → 空列表」;但未说明:从未在任何文章中出现过的 tag slug(例如拼写错误、乱打的 /tags/xyz/)是否与「有 tag、但暂时 0 篇」表现一致。

推荐:选项 A — 与「该标签下暂无文章」一致,统一为 200 + 空列表 + 简短说明。静态博客里不必区分「库里没有这个 tag」和「有这个 tag 但列表为空」,实现和测试都更简单,也和当前「默认不用误导性错误页」一致。
4. plan
这一步就开始落实到具体实现。之前跟 Agent 交流的时候,我简单说过想用什么技术栈来实现,它却直接回绝,表示这些内容应该写在 plan 中。
实际做需求时,也不该先看“我们手里有什么技术栈、它能做什么”,而是反过来让技术为需求服务:先明确需求,再判断当前技术是否足以支撑。我觉得这样的规划更合理。
你额外提到“用 HTML Canvas 实现游戏、Naive UI 作为组件库”。这是实现方案层面的约束,我不会写进 spec(避免让 spec 变成实现文档),我会在下一步 /speckit-plan 的技术方案里落实。
/speckit.plan 用 Canvas 实现游戏界面,Naive UI 作为项目的组件库可以看到,这个步骤的具体产物有这些:
- 计划文件,描述本次的特性总结和产出文件大纲: plan.md
- 研究结论,本次具体要实现的产物和技术栈选项: research.md
- 数据模型: data-model.md
- 运行验证,最小验证工作流: quickstart.md
- 合同(内部模块契约): contracts/game-module.md, contracts/maze-pathfinding.md
5. tasks
前面的步骤都有些抽象,而 tasks 这一步会根据之前的产物生成一份非常详细、可直接执行的任务拆解清单。
tasks 命令我认为也是 Spec Kit 的核心命令。它非常贴近日常研发工作,本质上是在把相对抽象的需求特性翻译成具体可执行的 checklist,再逐项落地。
这一步生成的任务拆解清单 tasks.md 内容如下:
- 前置检查:是否已切换了分支,并盘点影响的文件。
**Prerequisites**: plan.md (required), spec.md (required), research.md, data-model.md, contracts/, quickstart.md- 接着是任务清单本身,记录了每个文件的具体改动,比 Plan 阶段的描述更细,甚至能精确到文件里的方法。
- 比如要安装额外依赖、在指定位置创建文件夹,这些都是我们作为研发需要重点复核和斟酌的部分。
- 对于算法游戏,因为是初始化项目,所以
tasks.md里还会包含多个 phase 逐步演进。 - 博客网站项目就相对简单一些。
## Phase 1: Setup (Shared Infrastructure)

**Purpose**: Align dependencies and scaffold the planned structure.

- [x] T001 Add Naive UI dependency to package.json and install via lockfile update (package.json, package-lock.json)
- [x] T002 Update src/main.ts to register app-level providers needed for Naive UI usage (src/main.ts)
- [x] T003 Create source directories per plan structure (src/algorithms/, src/engine/, src/games/, src/platform/, src/**tests**/)- 还有 user story 描述具体使用案例,比如用户只能看到公开文章。每个 story 下都有 test,方便 Agent 检查 story 是否符合预期。
## Phase 3: User Story 1 - Choose & Play a Game (Priority: P1) 🎯 MVP

**Goal**: A user can open the platform, see a game list, start the Maze game, play a round, and see results.

**Independent Test**: Follow quickstart MVP flow steps 1–5 and confirm all navigation paths work without reload.

### Tests for User Story 1

- [ ] T014 [P] [US1] Unit test game registry lists the featured maze game (src/**tests**/games/registry.spec.ts, src/games/registry.ts)**Purpose**: 在内容解析层引入“可见性”能力,供所有页面复用
**⚠️ CRITICAL**: User Story 阶段任务依赖本阶段完成
- [ ] T004 在 `lib/posts.ts` 为 `PostMeta` 增加 `hidden: boolean` 字段(缺省为 `false`)
**Checkpoint**: `lib/posts.ts` 能区分公开/隐藏文章,且隐藏文章不会出现在任何聚合结果中能看到这里增加了很多 checklist。在执行下一步 implement 的时候,Agent 会按照这些 checklist 去验收,所以这个步骤的运行时间通常会相对更长。
## Phase 3: User Story 1 - 访客仅能看到公开文章 (Priority: P1) 🎯 MVP

**Goal**: 首页与博客列表不展示隐藏文章

**Independent Test**: 准备至少 1 篇隐藏文章后,访问 `/` 与 `/blog`,隐藏文章不出现在列表中;其他文章正常展示

- [ ] T010 [P] [US1] 验证 `app/page.tsx` 首页“最新文章”列表不会展示隐藏文章(依赖 `getAllPosts()` 输出)

**Checkpoint**: 仅完成 US1 仍可独立演示:隐藏文章不会出现在主要列表入口
6. implement
这一步就是根据 tasks.md 中的具体实现步骤来进行实际更改,在实现过程中还会对照 checklist,把已经完成的部分打勾记录。
因为具体步骤都已经写好了,所以也不是非得通过 Spec Kit 内置命令来实现,自己让 Agent 对着 tasks.md 去改也完全可行。
总结
开头的时候我也说过,我认为 Spec Kit 对已有项目,也就是项目架构和技术栈都已经确定的项目,贴合度会更高;对于从 0 到 1 的新项目,用起来则更容易失去掌控。
- 初始化阶段的技术栈选型、状态管理往往都还没有稳定下来,这时候一下子生成大量文件和代码,理解成本与维护成本都会迅速上升。
- 如果习惯了 Vibe coding的节奏, 本来就接受较高的不确定性,这套流程的约束价值可能没那么明显;但对专业开发来说,能否持续掌控 Agent 的产出依然是很重要的前提。
再说下 Spec Kit 的工作流程。
- 在实现特性的步骤中自动切换分支,这一点确实很方便。
/clarify这个命令非常加分。开发时如果 Agent 在特性边界不清楚的情况下就直接动手改,很容易产出后续维护成本较高的代码,最后还得开发者自己收尾。- 每个步骤都会产出一大堆文件,这是它的优点也是缺点
- 这些文件确实能帮助梳理需求,特别是对于复杂特性,checklist 能保证没有遗漏关键的 edge case。
- 比如我增加 tag 功能时,Agent 会帮我梳理出哪些路由需要增加、哪些文件需要修改、哪些测试用例需要补、哪些文档需要同步,而且这些文件都是模板化的,可以复用,所以不会平白增加太多工作量。
- 但它的代价也很明确。现在的主流思路通常是尽量压缩上下文,而 Spec Kit 反过来要求你保留更多过程文档,这意味着更高的 token 开销,也意味着更多阅读和维护成本。
- 所以我的判断是:对于复杂特性,这种约束和文档化是值得的;但对于很小的特性,它就会显得偏重。
参考
参考原作者 Den Delimarsky 的教程,视频里 Den 演示了如何通过 Spec Kit 在自己已有的博客项目里增加一个待阅读清单功能: